先把问题说透:企业主发现AI「乱说自己」通常有三种情况——第一种「说错」:AI把你2019年停用的设备说成现役,把旧产能数字当成现状;第二种「说旧」:DeepSeek引用你三年前的B2B平台介绍,资质年份、办公地址全是历史版本;第三种「不说」:问遍行业问题,答案里从来没有你。三者的成因不同,但解法同源:AI引用的质量由信源池的质量决定,纠错的本质是让「最新、正确、一致」的信息在AI可检索的范围内占据压倒性密度。本文给出定位问题、执行纠错、建立防错机制的全流程,特别针对DeepSeek的技术特性(工程师用户为主、检索偏好权威长文)给出适配方法。
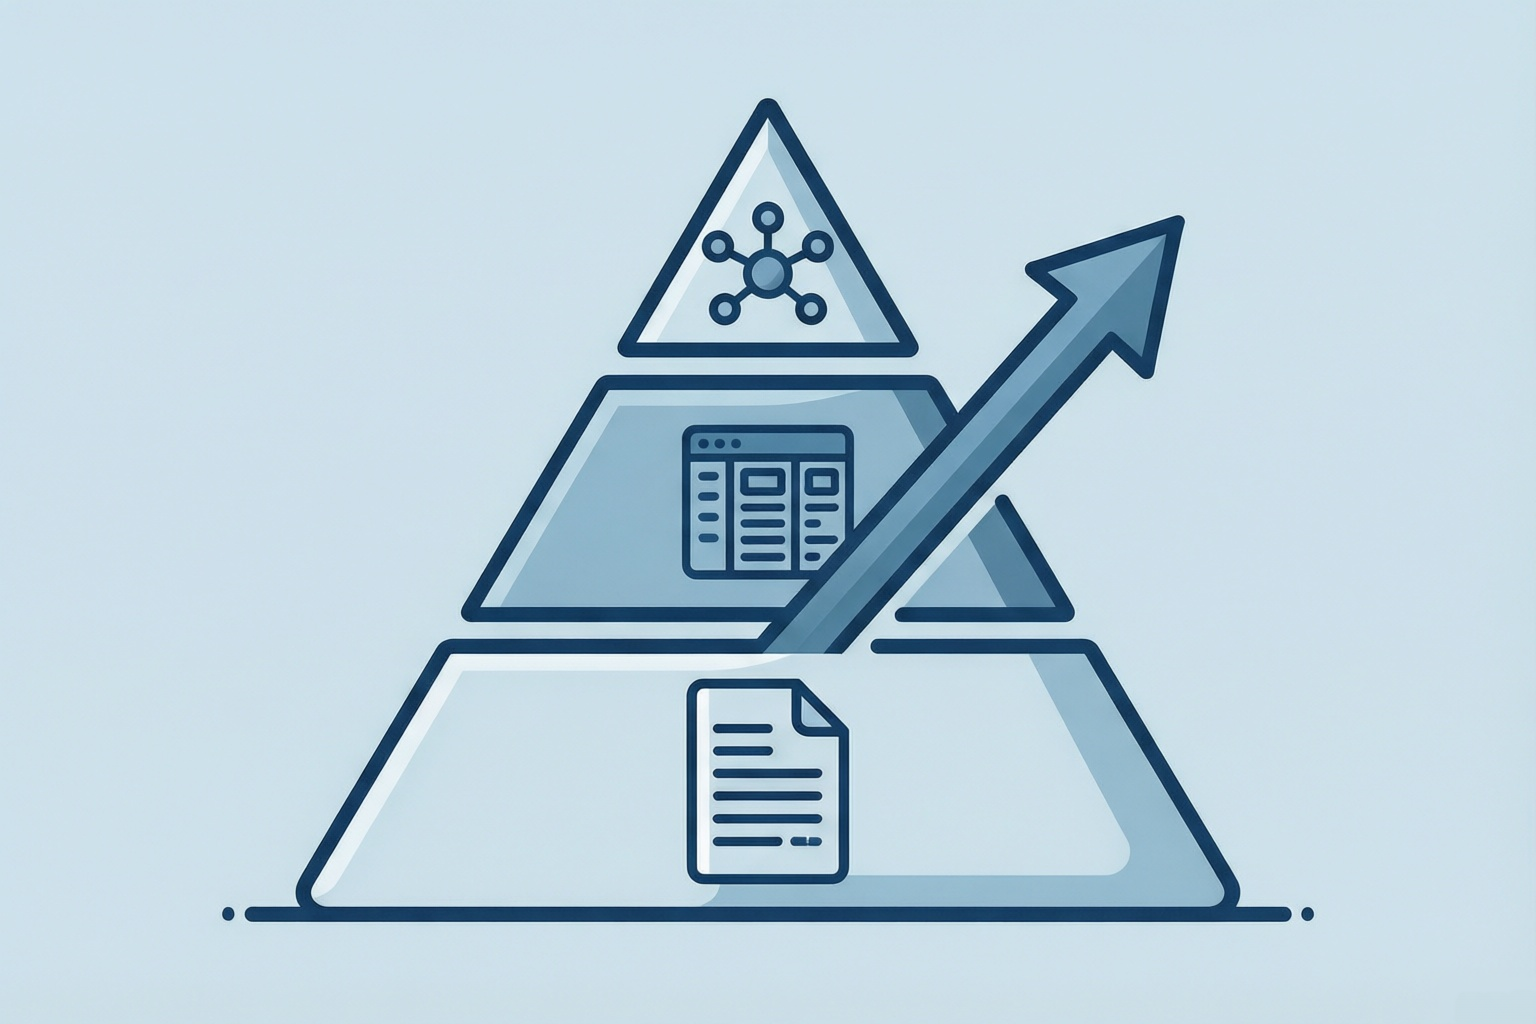
图1 AI引用的信息分层:答案的准确度取决于每层信源的新鲜度与一致性——任何一层出错都会污染最终答案
来源一:过期信源仍在线。大模型检索不默认按新鲜度排序,而按「可信度+相关度」——一个十年老站如果结构规整、被大量引用,DeepSeek照样优先摘它。大量无锡工厂的信息错误源自此:早年注册的B2B商铺、十年前的黄页条目、停更的企业博客,这些「数字化石」是错误引用的第一污染源。
来源二:多平台口径冲突。官网说员工58人、招聘页说100人以上、宣传册说300人——模型面对冲突时不猜,要么回避引用,要么随机采信一个并在答案里露出「据网络信息」的模糊措辞。口径冲突对采信度的伤害比信息缺失更大。
来源三:正确信息不可机读。企业的真实近况其实都写了——但在图片里(参数做成图片的产品彩页)、在PDF附件里(需下载才能看的价格表)、在微信公众号历史消息里(搜索引擎不收录)。DeepSeek抓不到这些载体,只能退回旧信源。「信息存在」和「信息可被AI获取」是两回事。很多老板自信「我们什么都有」,拿到的却是截图里的存在,不是引用里的存在。
各平台信源偏好有差异,纠错前先按平台对症下药。DeepSeek的特性:
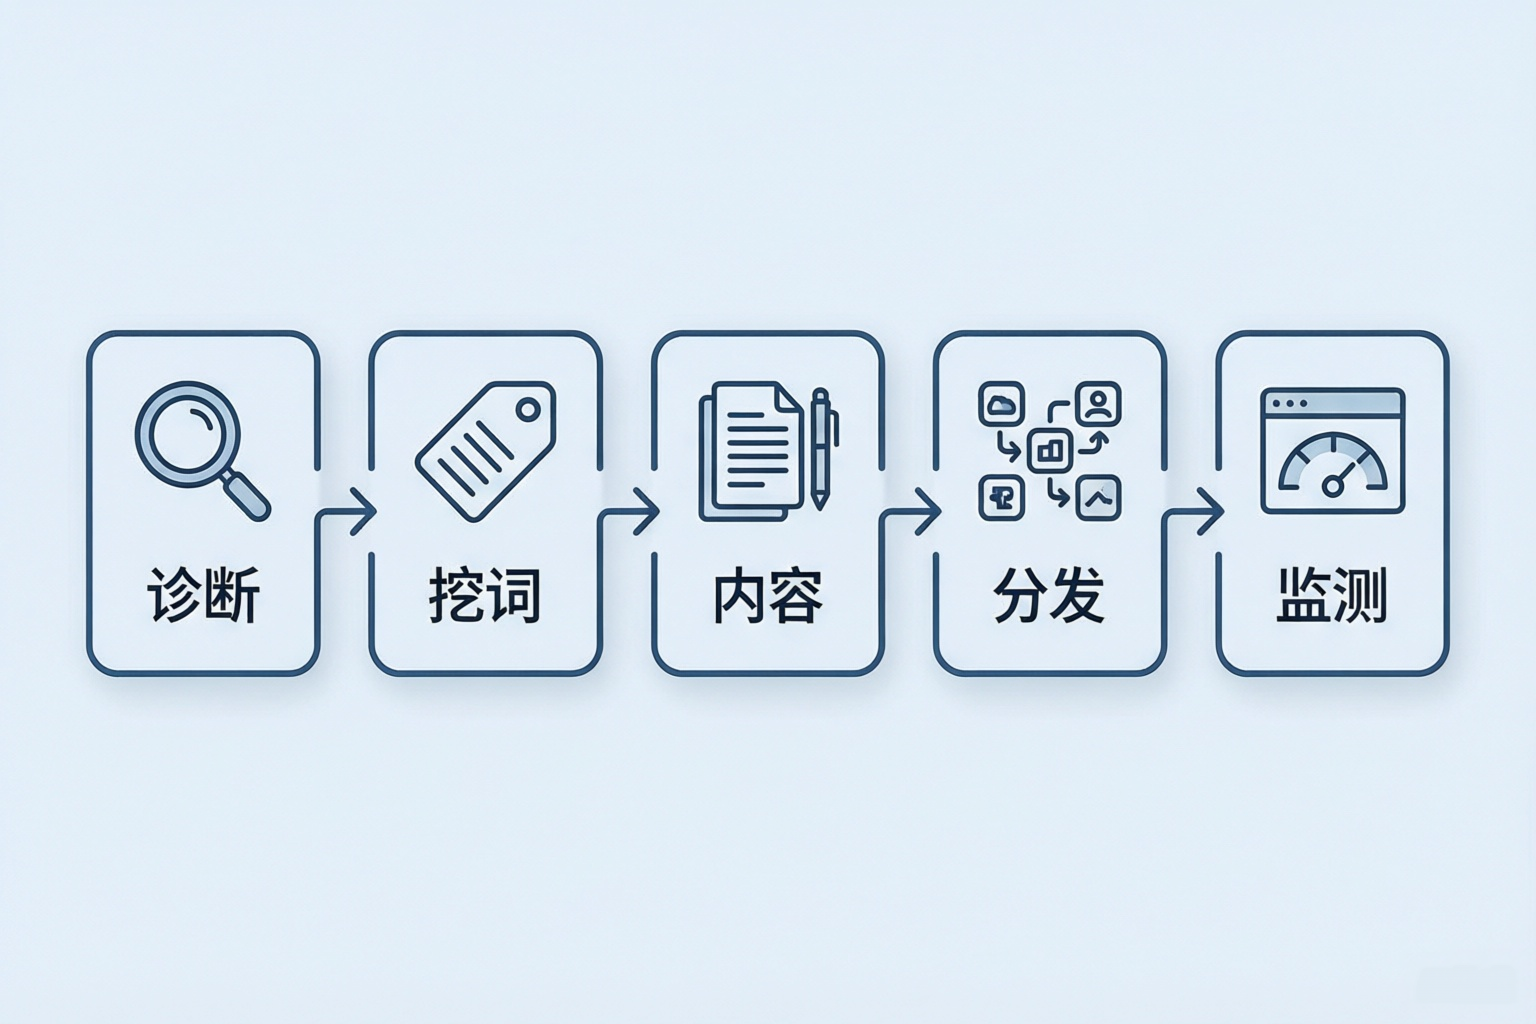
图2 GEO信源纠错标准工序:定位污染源 → 更新/申诉 → 正确口径加密 → 48小时复测闭环
第一步:定位(谁在替你说错话)。向DeepSeek提问出错的问题,展开答案的参考来源列表,逐个核查引用页面:哪个平台、什么时间更新、错误内容具体是什么。制造业最常见的污染源排序:过期B2B商铺 > 二手行业信息站抓取页 > 停用多年的自建博客 > 错误百科词条。
第二步:清除与更新。能自主控制的(自家旧站、旧商铺)直接更新或下线;不可控的平台走内容申诉/更新申请通道(主流B2B与百科类平台均有企业认领与信息更新机制);纯抓取站无法删除的,用第三步的密度策略压过它。
第三步:正确口径加密。在官网发布带明确日期与版本的「企业信息页」(公司简介、产能设备、资质清单各一页,页面标注「最后更新」时间戳),部署Organization与Product Schema;围绕错误涉及的维度定向发布结构化内容3~5篇(错误说产能500万,就发带数字与日期的产能说明长文),覆盖DeepSeek偏好的权威长文形态。原理:检索是概率游戏,正确信息在信源池的密度压倒错误信息后,引用会自然收敛。
第四步:复测与固化。纠错动作后第7天、第30天用原问题复测DeepSeek与其余四平台,记录答案变化;同时把该问题加入常测问题池。月度巡检「口径一致性」:官网、平台、百科三处关键数字逐项比对,防患于未然。
实际项目里,八成以上的引用错误落在四个固定场景,每个场景都有标准处置路径:
错误场景 | 典型表现 | 根因 | 处置要点 |
产能/设备数据陈旧 | AI引用的还是五年前的设备清单与产能 | 旧B2B商铺页未被抓取覆盖 | 官网发布带更新日期戳的产能页 + 同主题长文加密 + 旧商铺页认领更新 |
地址与区域归属错误 | 公司在新吴,AI说在武进或标注外地分部地址 | 历史搬迁记录与第三方黄页错标 | LocalBusiness Schema标注准确地址,NAP全平台巡检,向错标平台提更新 |
竞品信息串台 | AI把同行参数安在你头上(同名简称、同品牌词高发) | 语料中两企业实体区分度低 | 强化企业全称+独有产品型号的可识别锚点,发布参数对照类内容帮模型区分实体 |
经营状态误判 | AI暗示企业已停业/涉诉(引用了过期黄页或同名主体信息) | 同名企业信息混入、旧工商快照 | 官网企业页部署Organization+sameAs指向工商公示与认证平台,用权威来源覆盖旧快照 |
这四类里制造业最疼的是第三类「串台」:企业名称简称雷同、产品型号撞名时,AI的实体区分能力取决于语料中独有锚点的密度。处置不是投诉,而是加密:把自己的全称、注册商标号、独有产品系列名高频出现在结构化内容里,给模型足够的区分线索。邦程在客户项目里发现过连续三家企业简称撞名的细分赛道,串台修复后相关询盘的有效率明显回升——这类隐形损失在传统SEO指标里完全看不见,正是GEO监测存在的价值。
纠错是被动的,成熟企业要做的是把「不被引错」变成体系。邦程在企业GEO全案里固定交付三项防错基建:
制造业对这套机制的敏感度远高于其他行业:一个错误的精度参数引用,可能带来几十单做不了的询价,销售解释的成本远超GEO投入本身。
Q1:直接向DeepSeek官方申诉错误答案有用吗?产品内反馈入口存在,但对历史引用影响有限,不要指望「投诉改答案」。有效路径始终是改信源:AI的答案跟着资料走,资料改对了,答案自然改对。
Q2:竞品恶意内容导致AI对我评价不准怎么办?先固化己方权威口径(事实库+官网结构化内容),再对具体不实页面走平台投诉与法律函件;若涉行业对比类内容,用中性的参数对照表内容占位,让AI在对比时有更完整的数据可引用。对抗性内容战在GEO里性价比极低,建设永远优于对抗。
Q3:我们信息太少,AI压根没引用过,属于哪种问题?是第三种的镜像:不是引错,是无处可引。执行顺序反过来——先补内容密度(问题池驱动的主题集群),再建防错基建;引用从无到有时,宁可从准确的小口径起步,也不要在扩量时留下数字漏洞。
Q4:模型大版本更新后之前做对的会失效吗?部分会。更新影响语料与检索偏好,实测经验是本地品牌类、参数类引用稳定,行业推荐类位次会有扰动。邦程全案服务里包含版本更新后48小时全池重测与策略再校准。
Q5:百科词条写好了为什么AI还是不用?两个常见原因:词条内容本身是宣传体而非事实体(无来源标注的形容词段落会被跳过),或者词条太新尚未被检索池吸收。正确姿势:词条只写可验证事实并逐项标注权威来源,建好后再用同主题长文在其周围形成信源密度——百科是节点,密度网络才是引用保障。
Q6:多语言站点的错误引用怎么排查?用目标语言重复同一套流程:以海外站的品类英文句式向ChatGPT/Gemini提问,展开来源清单定位错误页面(重点排查十年前的出口平台英文商铺页);中文站的修正动作不会传导到英文信源池,两边必须分别监测、分别纠错。
DeepSeek、豆包们的答案正在成为企业的「数字分身」——客户第一面看到的不是你的宣传册,而是这段分身怎么说你。分身说错话,根因从来不在分身嘴笨,在你递出去的资料旧、乱、缺。所以这套纠错与防错体系一句话总结:让AI准确引用你的前提,是让企业自己的数字世界只存在一个版本的真话。这件事,和把产品做好一样,靠的是长期主义的品控——只不过品控的对象从工件,换成了信息资产。先把这套品控体系建起来的企业,将来每一次被AI提及都在吃自己品控的红利。
本文流程基于邦程科技GEO代运营项目信源纠错实操复盘总结,各平台申诉机制与抓取策略随版本变化,以月度实测数据为准动态调整。